
Kandinsky Lab выпустила семейство моделей Kandinsky 6.0 Video, которые создают видео и звук одновременно. Пользователь может описать сцену текстом или загрузить картинку и задать, что должно произойти дальше.
Kandinsky 6.0 Video генерирует пятисекундные ролики с синхронной звуковой дорожкой, включая речь и движения губ. Доступны две версии: Lite с 3 млрд параметров и Pro с 29 млрд.
Читайте также: ТОП-5 бесплатных нейросетей для создани видео
Нейросеть Kandinsky 6.0 Video — что умеет и как работает
В основе Kandinsky 6.0 — два потока, отвечающих за видео и аудио. Они связаны двунаправленным cross-attention и во время генерации обмениваются информацией, чтобы события в кадре и звуки совпадали по времени и смыслу.
Для генерации по изображению загруженная картинка задаёт первый кадр, а текстовое описание — дальнейшее действие. Модель подгоняет исходное изображение под размер ролика и при необходимости обрезает его по центру.
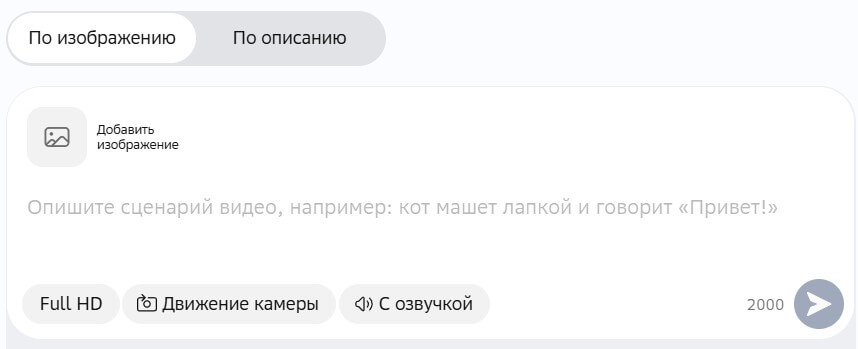
Звук генерируется с частотой дискретизации 44 кГц. Отдельная модель суперразрешения позволяет масштабировать видео вплоть до Full HD — 1920 × 1080 пикселей.
По результатам попарного сравнения роликов участниками исследования версия Pro превосходит Kandinsky 5.0 Video Pro. Авторы также сравнивают модель с другими системами генерации видео и аудио и отмечают высокое качество синтезированной речи.
Как пользоваться
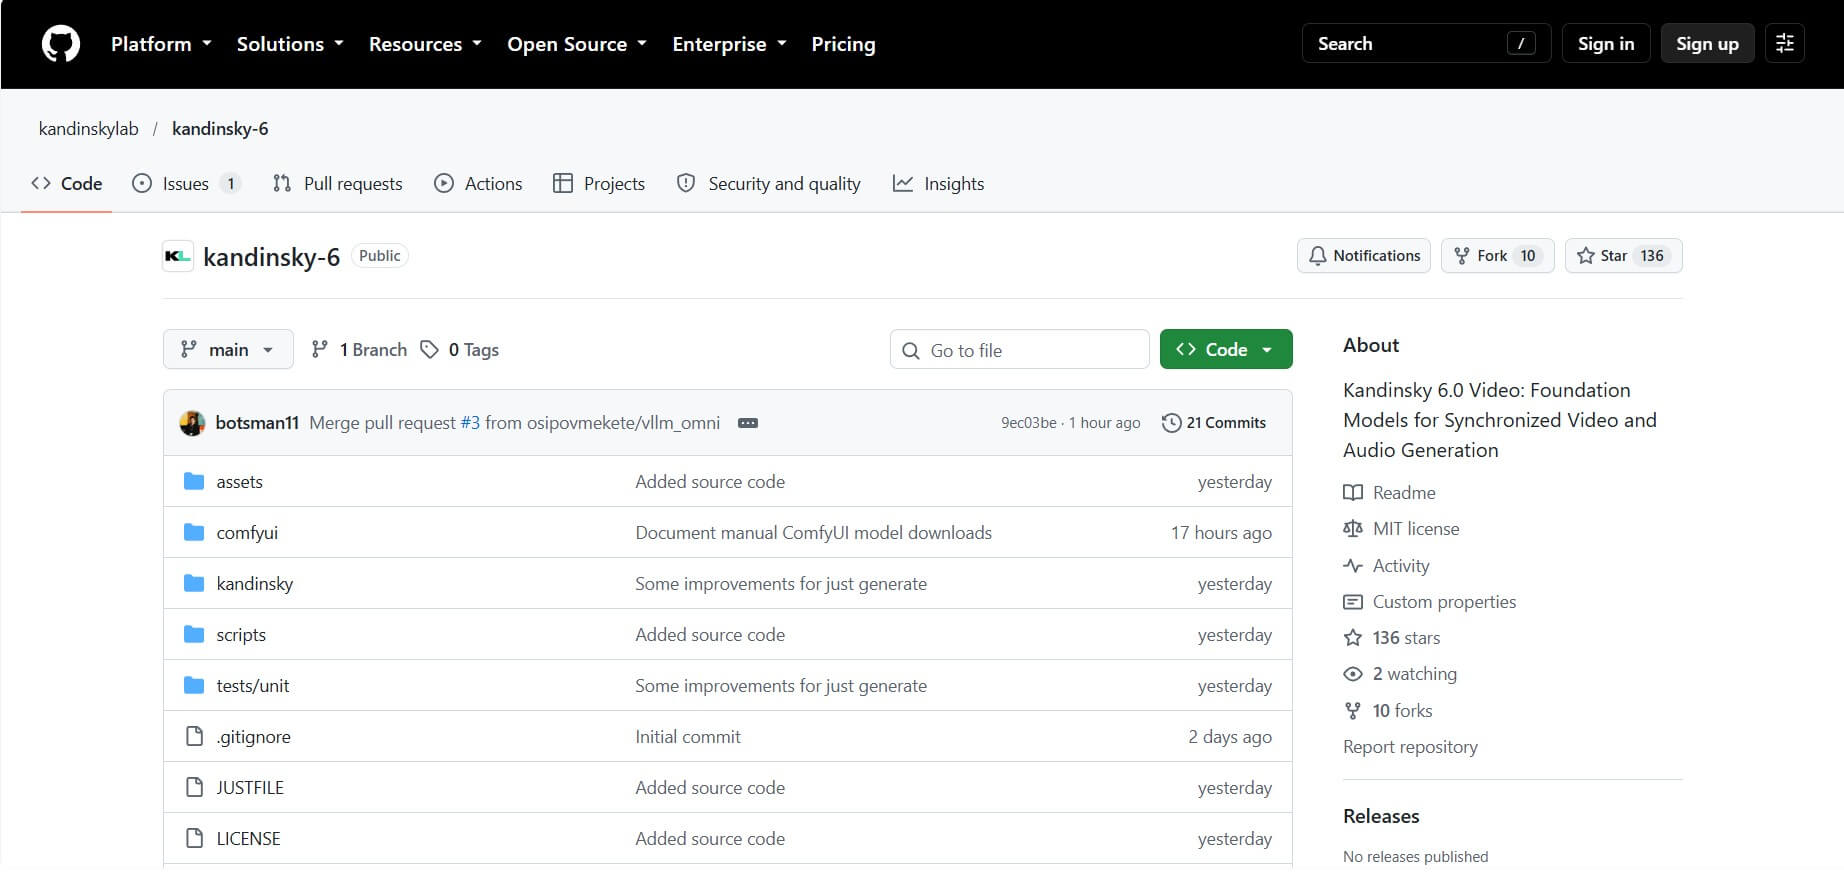
Код и веса Kandinsky 6.0 опубликованы 6 октября 2026 года под лицензией MIT. Помимо основных моделей, доступны ускоренные версии Lite Distill и Pro Distill.
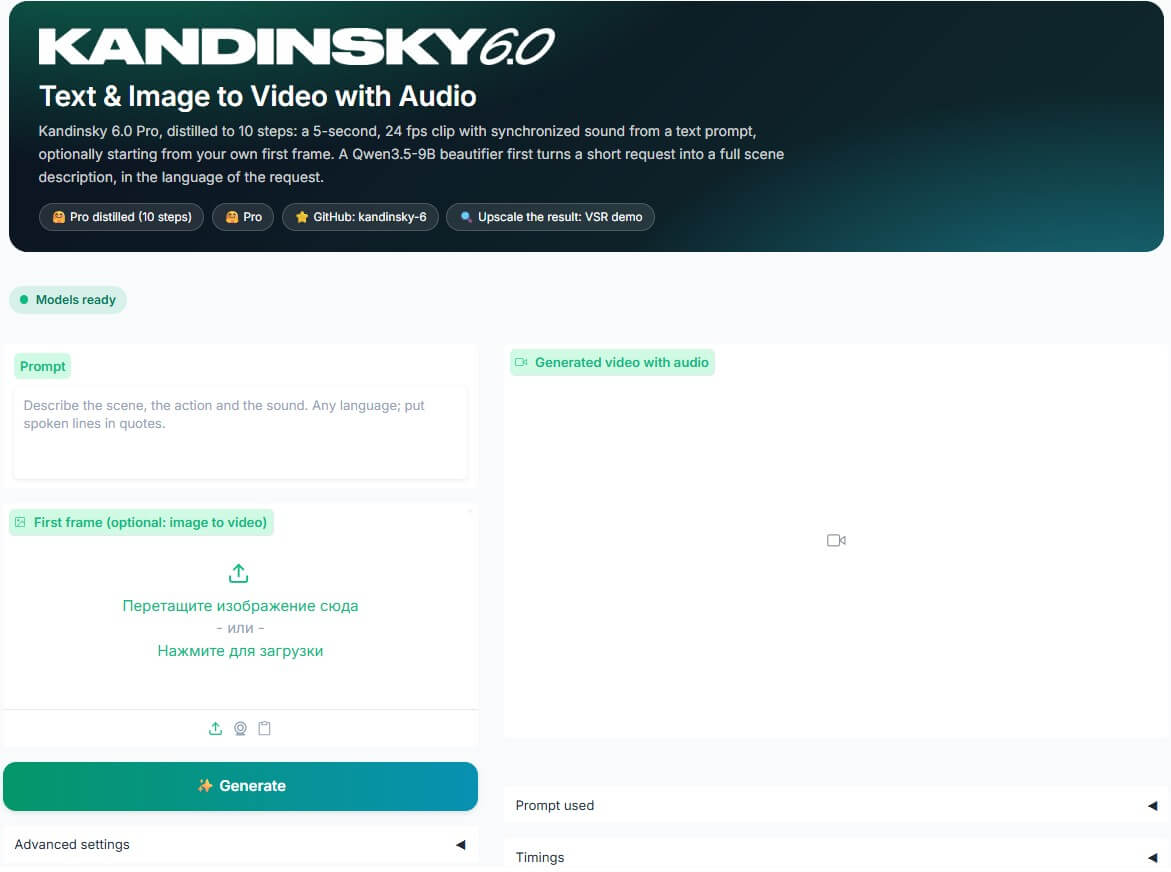
Для Pro Distill открыт демонстрационный сервис на Hugging Face. Модели также можно запускать через Diffusers и ComfyUI. Инструкция для самостоятельной установки из репозитория требует видеокарту NVIDIA и Python 3.13 или 3.14.
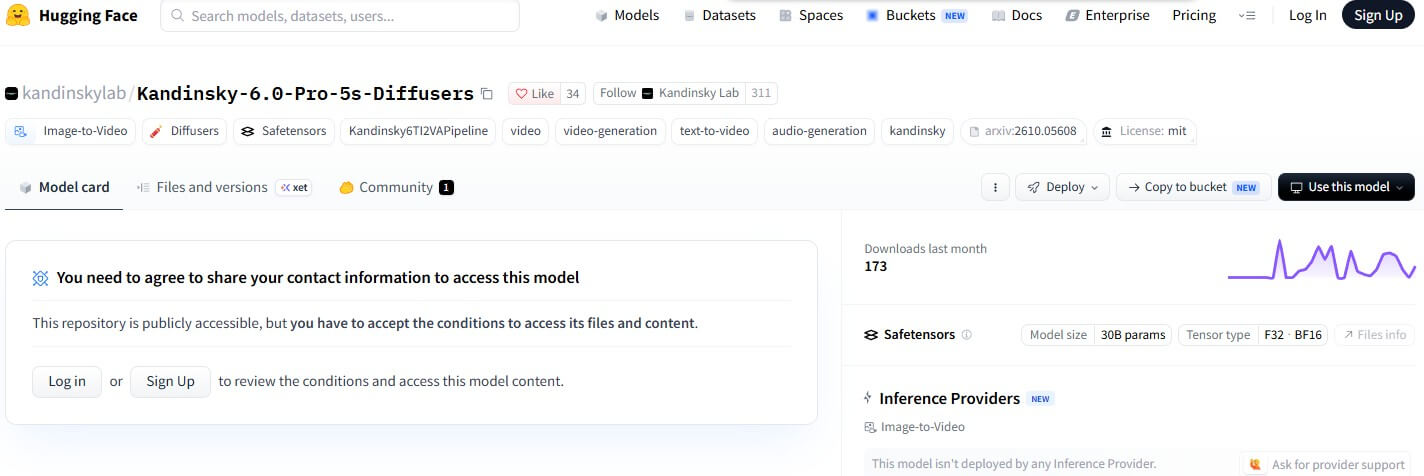
Чтобы скачать файлы основной Pro-модели из Hugging Face, нужно войти в аккаунт, принять условия доступа и согласиться передать контактные данные.
Ранее Сбер выпустил Kandinsky 6.0 Image — нейросеть для генерации и редактирования изображений в ГигаЧате.