Tencent официально выпустила HunyuanImage 3.0 — крупнейшую на сегодня открытую модель для генерации изображений по текстовому описанию. Она насчитывает 80 млрд параметров, при этом во время инференса задействуется около 13 млрд.
По словам команды, результат сравним с качеством ведущих закрытых моделей. Postium подготовил подробный обзор новой ИИ-модели для создания картинок.
Читайте также: 25 нейросетей для генерации картинок
Что умеет нейросеть HunyuanImage 3.0
HunyuanImage 3.0 создана на базе MoE-архитектуры (Mixture of Experts) и объединяет языковую и визуальную модель в единую систему. В отличие от традиционных диффузионных генераторов (DiT), здесь используется «трансфузионный» подход — плотная связка Diffusion и LLM-тренировки.
Это позволяет не только создавать картинки, но и осмысленно работать с длинными промтами для генерации изображений, учитывать «мировые знания» и аккуратно встраивать текст в изображения.
Что это значит на практике:
- Поддержка длинных запросов до 1000+ слов.
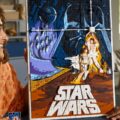
- Генерация читаемого текста на изображениях (постеры, комиксы, инфографика).
- Работа со сложными стилями — от эмодзи и комиксов до образовательных иллюстраций.
- Более быстрый отклик: процесс занимает минуты, а не часы.
Как обучали модель? Tencent заявляет о крупнейшем мультимодальном датасете в своей линейке: 5 млрд пар «текст–картинка», видеокадры и смешанные данные «текст + изображение», 6 трлн токенов текстовых корпусов.
Базой для модели послужил Hunyuan-A13B, мультимодальный LLM. Такой гибридный тренинг делает HunyuanImage 3.0 универсальной: она может совмещать задачи понимания текста и генерации изображения в одном шаге.
Статья в тему: Промты для обработки фото в ChatGPT
Как пользоваться HunyuanImage 3.0
1. Через официальный сайт. Перейдите на hunyuan.tencent.com/image и нажмите «Авторизоваться» в правом верхнем углу. Интерфейс пока доступен только на китайском, поэтому удобнее включить автоматический перевод в браузере.

Авторизация через e-mail: введите свою почту, нажмите «Получить код» и используйте его в качестве пароля (обычного пароля здесь нет).

После входа выберите вкладку «Визуальная генерация» — это второй пункт меню справа.

Откроется окно генерации. По умолчанию стоит модель 3.0, но можно проверить настройки.

Введите промт (описание картинки) и получите результат за пару минут. Полученную картинку можно скачать или попросить сгенерировать ещё раз.

2. Через Hugging Face. Модель доступна в каталоге Hugging Face. Можно запускать через transformers или попробовать демо в браузере.
3. Локальный запуск. Код и веса (≈170 ГБ) опубликованы на GitHub. Для работы потребуется минимум 3–4 GPU по 80 ГБ. Есть оптимизация FlashAttention и FlashInfer для ускорения.
Вероятно, модель вскоре появится у партнёров.
В начале сентября Tencent выпустила HunyuanImage 2.1 (17B) — диффузионную модель с рефайнером, которая стала лидером в открытых бенчмарках T2I.
Параллельно компания развивает Hunyuan-LLM и HunyuanVideo. С релизом 3.0 Tencent делает ставку на единую архитектуру, которая объединяет текстовые и визуальные задачи в одном фреймворке. В планах добавить image-to-image, редактирование картинок, многошаговые диалоги с моделью.
Ранее Wan 2.5 добавила генерацию видео по звуку.