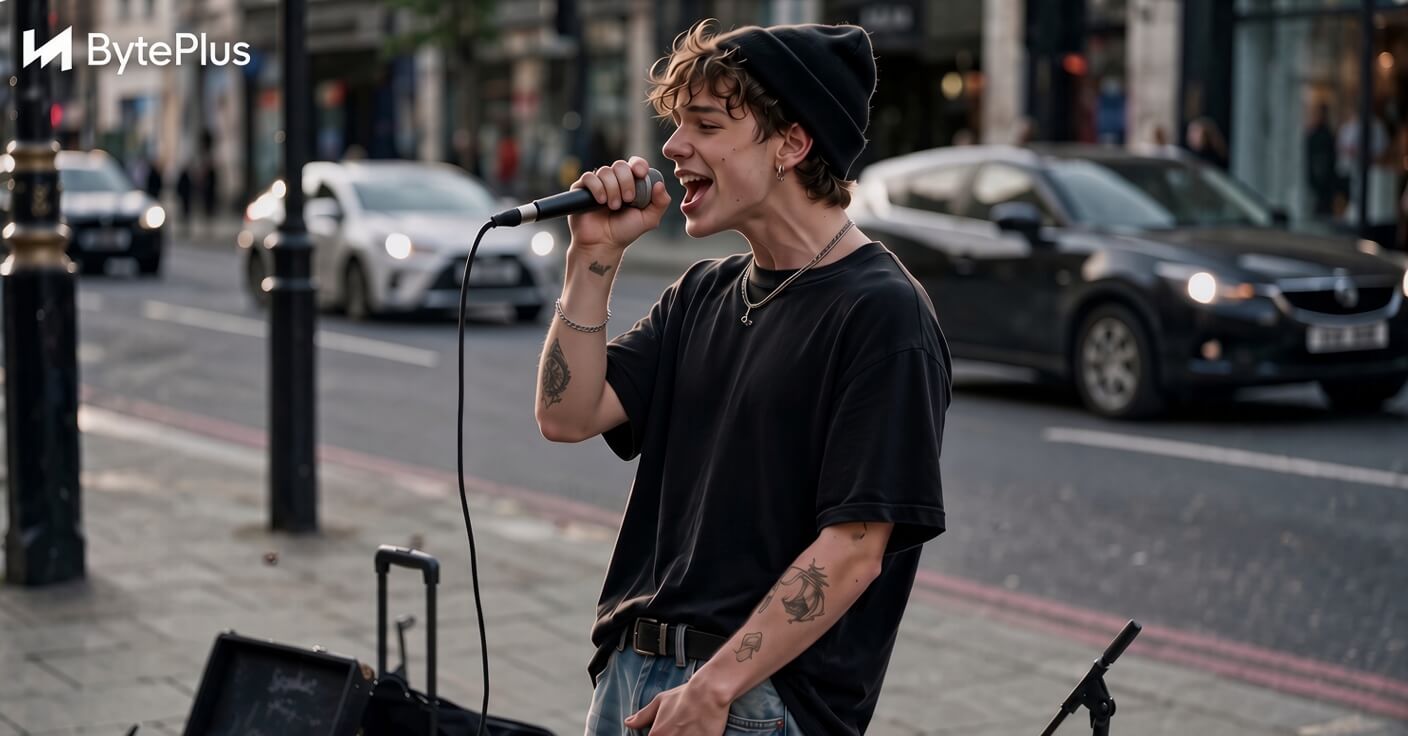

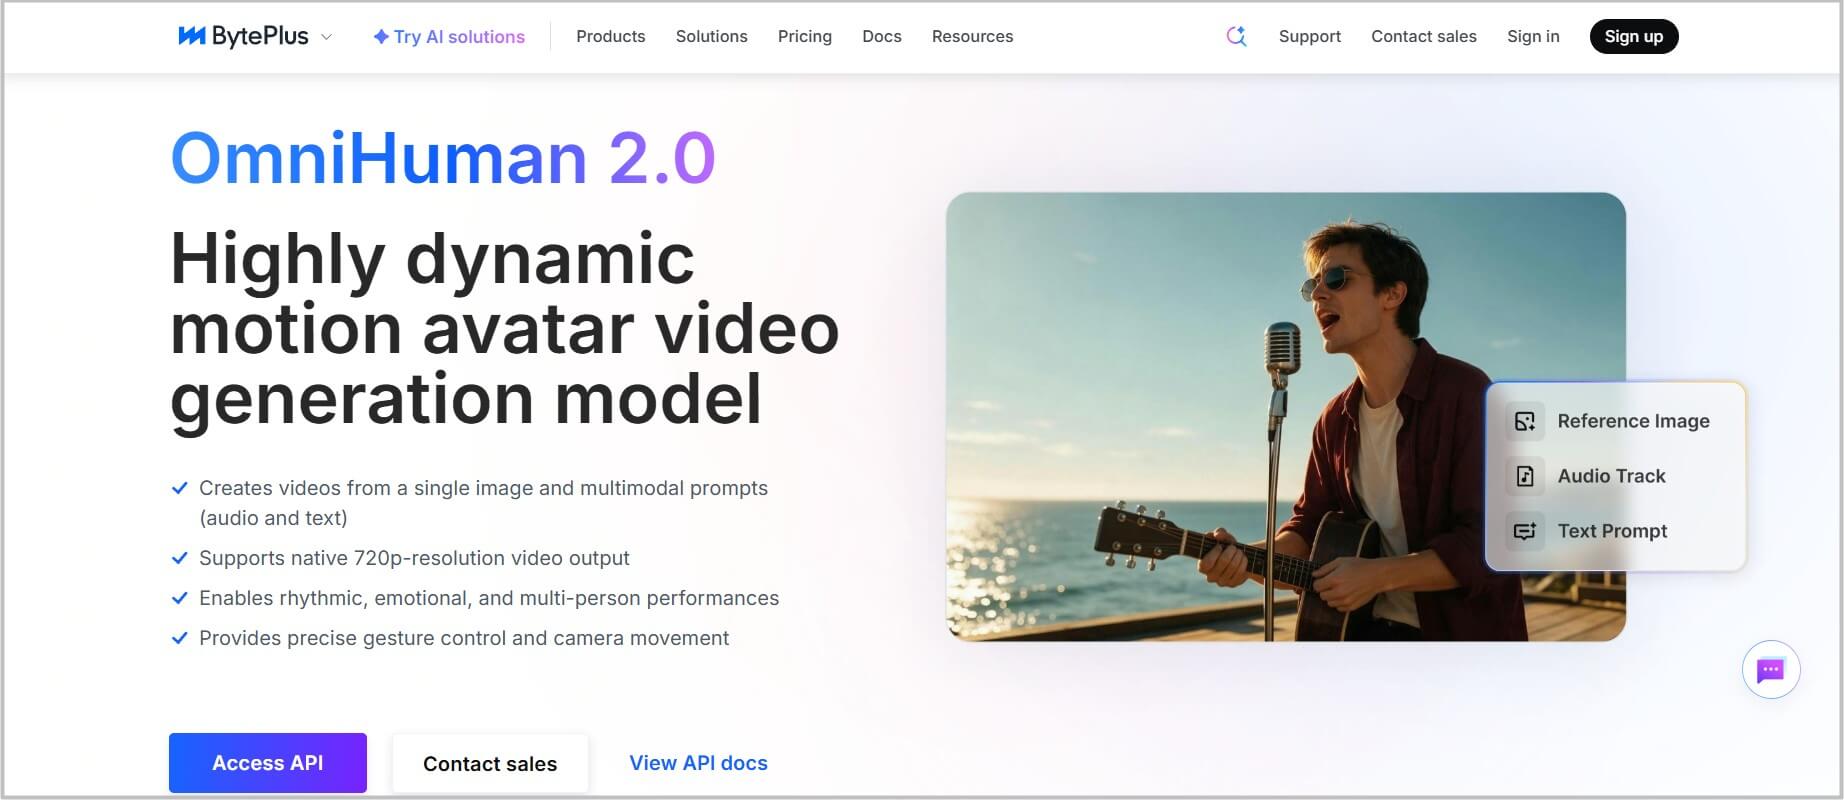
BytePlus (подразделение ByteDance) представила OmniHuman 2.0 — модель для создания видео на основе изображения и аудиозаписи. Она синхронизирует движения губ, мимику и жесты с речью или музыкой, учитывая интонацию, эмоции и смысл аудио.
Длительность роликов может достигать пяти минут. Для генерации нужны изображение персонажа и звуковая дорожка. Текстовый запрос позволяет уточнить его поведение, задать действия и управлять движением камеры.
Читайте также: ТОП-25 нейросетей для создания изображений
Как работает OmniHuman 2.0
Модель подстраивает движения персонажа под содержание аудиозаписи. При разговоре она синхронизирует артикуляцию, мимику и жесты с речью, а при пении учитывает ритм и паузы.
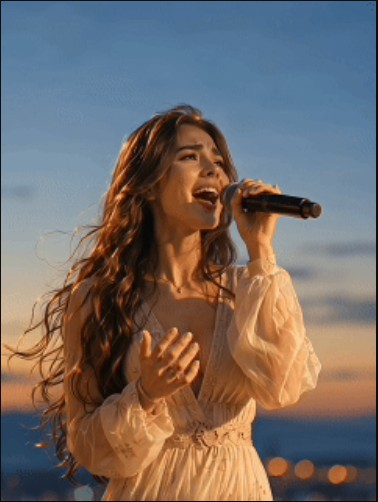
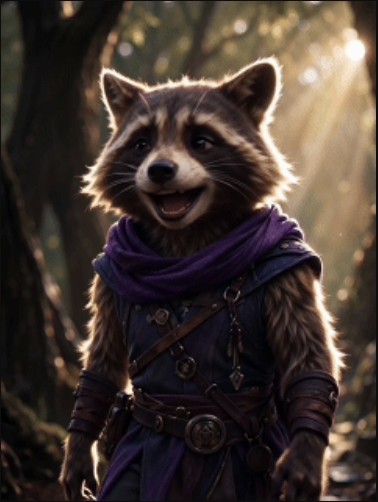
С помощью текстовых инструкций можно задать конкретные действия, изменить движение камеры и добавить в сцену объекты, которых нет на исходном изображении. Модель также поддерживает изображения с несколькими людьми, анимацию животных, мультяшных героев и трёхмерных персонажей.

BytePlus показывает работу OmniHuman 2.0 на примерах анимации животных и сцен, в которых действия персонажа соответствуют смыслу аудиозаписи. Среди возможных сценариев применения — создание рекламных роликов, музыкальных клипов и другого видеоконтента.
Часть этих возможностей была и в OmniHuman 1.5. В предыдущей версии разработчики также демонстрировали управление движением камеры и взаимодействие нескольких персонажей. В OmniHuman 2.0 акцент сделан на более точной связи движений и поведения героя с содержанием аудио.

Доступ и стоимость
OmniHuman 2.0 доступна через консоль BytePlus и API.
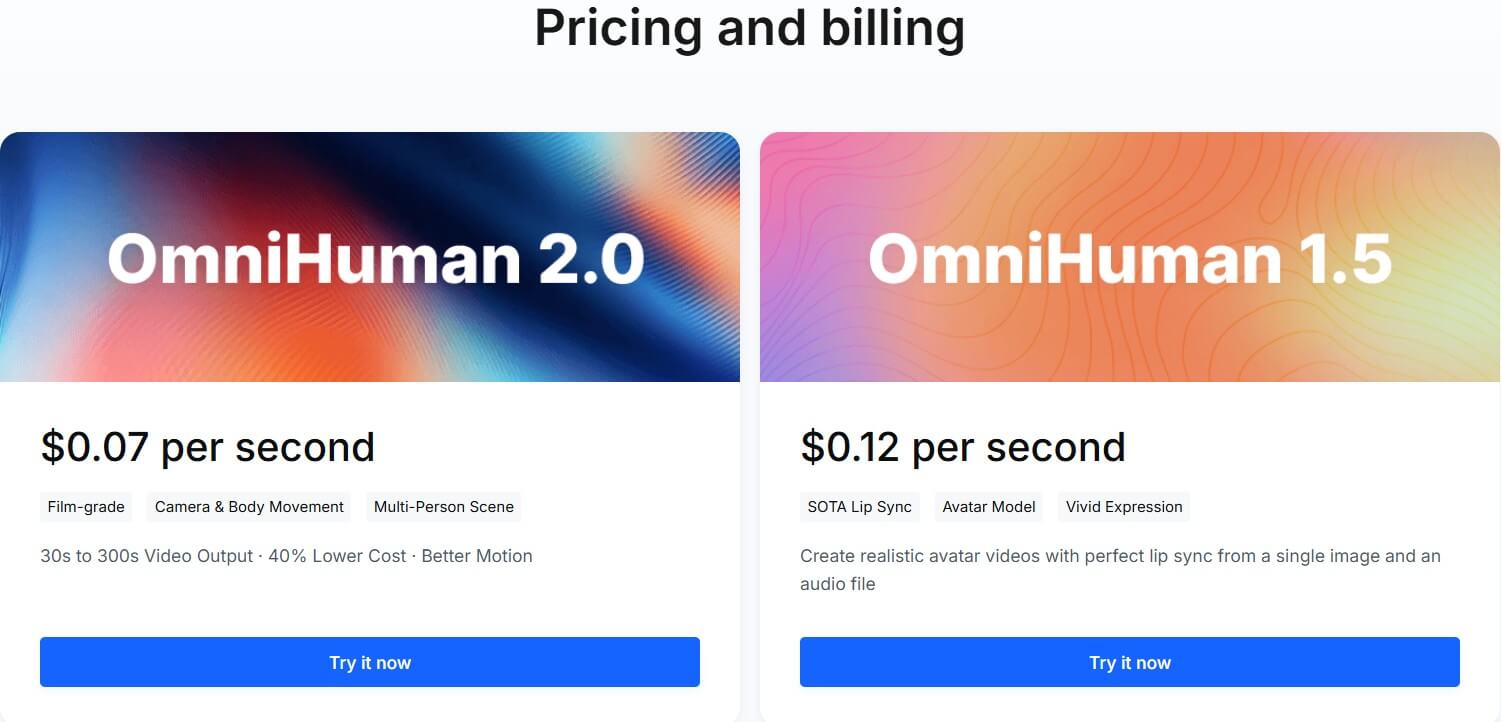
Стоимость генерации составляет $0,07 за секунду видео — примерно на 40% меньше прежнего тарифа. Пятиминутный ролик при такой ставке обойдётся в $21.
Ранее BytePlus представила Seed Speech 2.0 — ИИ-платформу для генерации и распознавания речи.
Изображения: byteplus.com