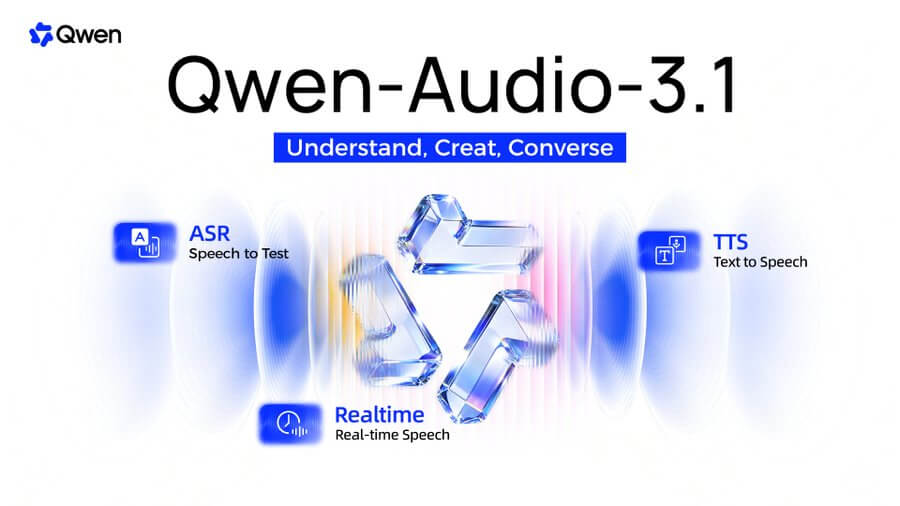
Alibaba представила семейство Qwen-Audio-3.1 из пяти моделей: для распознавания речи, синтеза голоса, голосового диалога, создания звуковых сцен и анализа аудиозаписей. Компания обновила ASR, TTS и Realtime и добавила две модели — TTS-Next и ASR-Next.
TTS-Next собирает речь, эффекты и фоновые звуки по сценарию. ASR-Next распознаёт в записи не только слова, но и эмоции и звуки окружения. Отдельная API-документация для ASR-Next пока не опубликована.
Читайте также: ТОП-7 нейросетей для создания видео
TTS-Next создаёт озвучку со звуковыми эффектами
Qwen-Audio-3.1-TTS-Next принимает текст, временные метки и образцы голосов. По одному заданию модель может озвучить диалог нескольких персонажей и добавить звуки окружения — например, шум улицы под реплики. Такой результат нужен для подкастов, роликов, игр и аудиокниг.
Согласно документации Alibaba Cloud, модель работает с китайским и английским языками, принимает до трёх эталонных аудиофрагментов и выдаёт WAV, MP3 или PCM. За один запрос можно получить до четырёх минут подкаста; для остальных сценариев предел — две минуты. Модель также поддерживает вывод в 48 кГц и детальный контроль временных меток. Сервис возвращает готовый файл, а не поток звука во время генерации.
ASR-Next анализирует запись, ASR расшифровывает речь
ASR-Next рассчитана на анализ аудио: компания заявляет распознавание эмоций говорящего, фоновых и механических звуков, поиск звуковых событий по времени и ответы на вопросы о записи. Отдельная API-документация для ASR-Next пока не опубликована.
Обновлённая Qwen-Audio-3.1-ASR преобразует речь в текст на 30 языках и 16 китайских диалектах. Она может указать говорящего и время каждой реплики, убрать слова-паразиты и повторы. По данным Qwen, на открытых наборах KeSpeech и WSYue средняя доля ошибочно распознанных иероглифов составила 4,55% на 11 поднаборах. Это результат указанного теста, а не обещанная точность для любой записи.
TTS и Realtime обновили голосовые сценарии
Qwen-Audio-3.1-TTS синтезирует речь и позволяет управлять подачей: задавать эмоцию, темп и манеру произнесения. Компания также заявляет сохранение характера голоса при переключении языка.
Qwen-Audio-3.1-Realtime предназначена для диалога голосом в реальном времени. Ассистента можно перебить во время ответа; модель поддерживает смену языка по ходу разговора и вызов инструментов. Эти функции нужны, например, голосовому помощнику, который отвечает на вопросы и выполняет команды.
Как получить доступ
На Qwen AI Platform опубликованы страницы ASR, TTS, TTS-Next и Realtime. Alibaba Cloud отдельно описала подключение TTS-Next через Model Studio. Отдельная API-документация для ASR-Next пока не опубликована.
Одновременно Qwen сообщила о снижении цен на голосовые модели: ориентировочно на 70% для TTS, на 85% для Realtime и до 95% для ASR. Конкретная стоимость зависит от выбранной модели и площадки подключения.
Ранее Alibaba выпустила Qwen-Image 2.1 с генерацией прозрачных изображений.
Изображение: x.com/Alibaba_Qwen/status/2102687258990026993